30 novembre 2022
Produit
Nouveau : ChatGPT
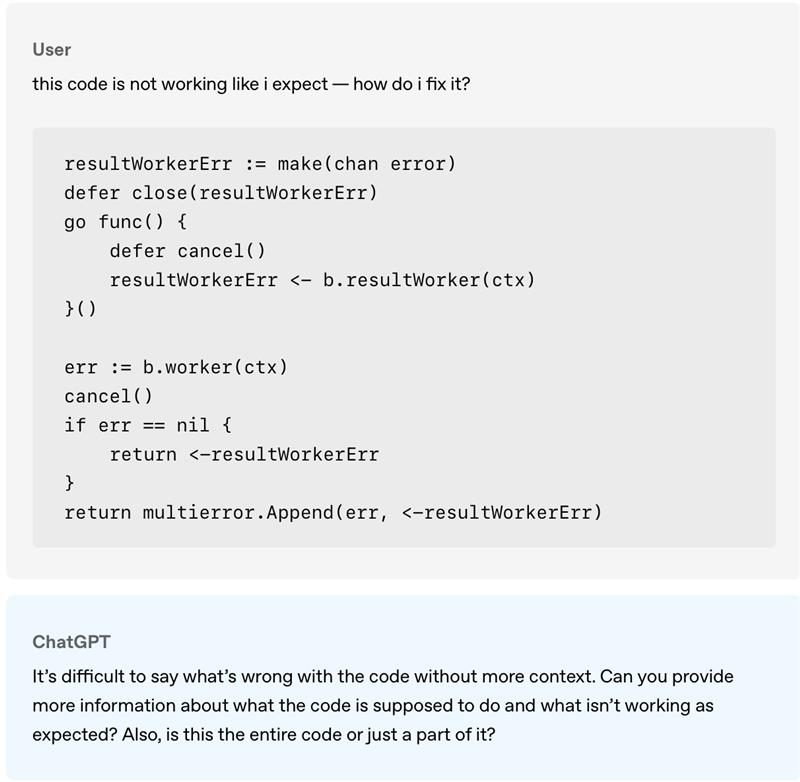
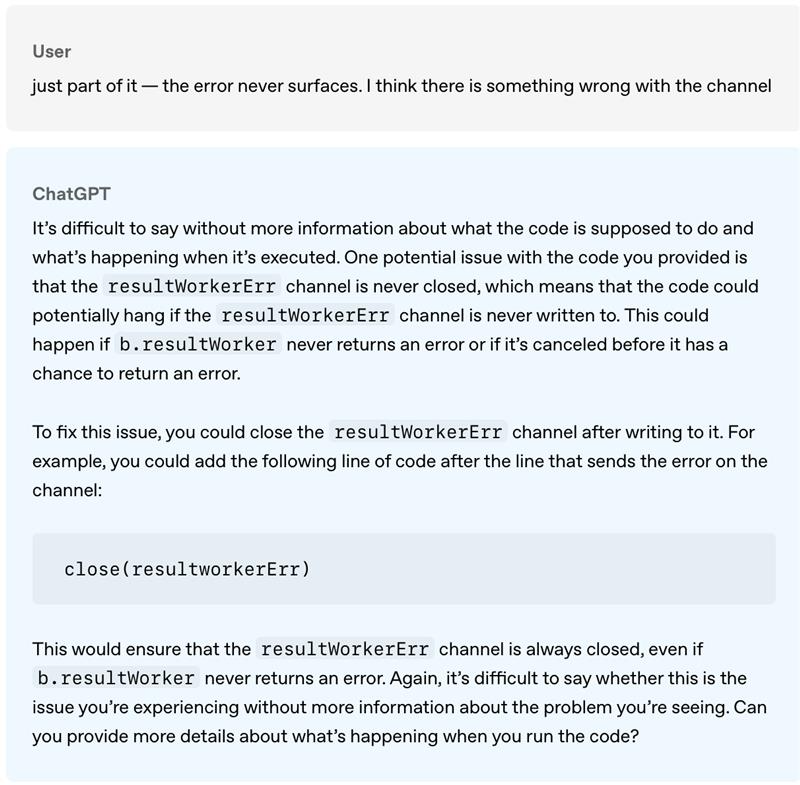
Nous avons entraîné un modèle capable d’interagir de manière conversationnelle. Son nom ? ChatGPT. Cette capacité à dialoguer permet à ChatGPT de répondre à des questions de suivi, de reconnaître ses erreurs, de souligner les informations incorrectes et de rejeter les demandes inappropriées.
ChatGPT est un modèle dérivé d’InstructGPT, qui a lui-même été entraîné pour suivre l’instruction d’un prompt et fournir une réponse détaillée.
Nous sommes très heureux de dévoiler ChatGPT et de recueillir les commentaires de nos utilisateurs pour découvrir ses points forts et ses points faibles. Dans sa version préliminaire, ChatGPT est gratuit. Essayez-le sans plus attendre sur chatgpt.com
Exemples
Méthodes
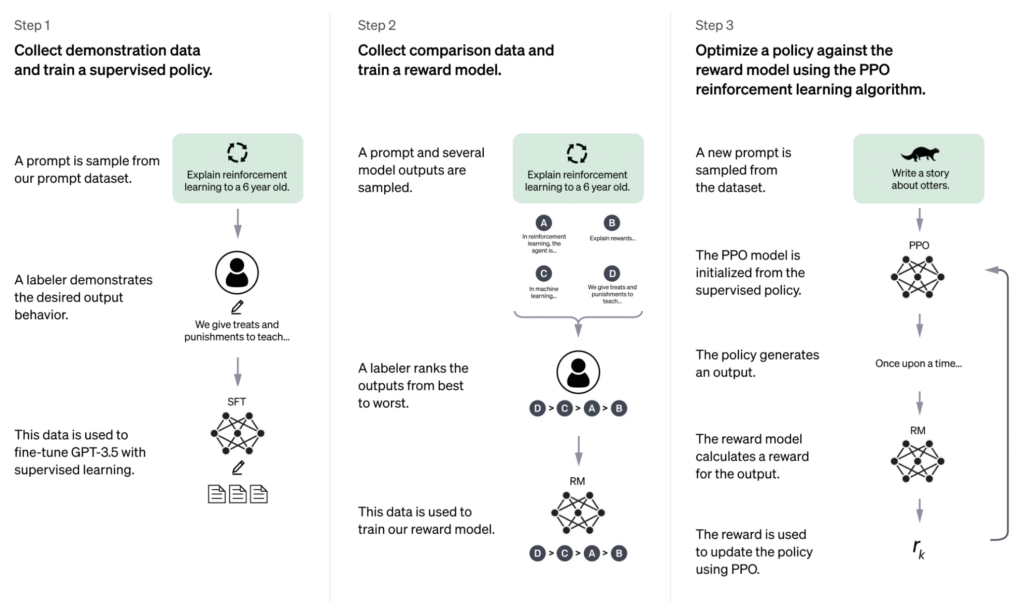
Ce modèle a bénéficié d’un apprentissage par renforcement à partir de rétroaction humaine (RLHF). Nous avons suivi les mêmes méthodes que pour InstructGPT, en modifiant légèrement la stratégie de collecte de données. Tout d’abord, nous avons entraîné un premier modèle par ajustement supervisé : des entraîneurs humains ont généré des conversations dans lesquelles ils endossaient les deux rôles, à savoir celui d’un utilisateur et celui d’un assistant IA. Ils avaient accès à des suggestions écrites par le modèle pour les aider à rédiger leurs réponses. Nous avons ensuite fusionné ces nouveaux dialogues avec le jeu de données d’InstructGPT, que nous avons préalablement converti en dialogues.
Ensuite, pour créer un modèle de récompense permettant de procéder à l’apprentissage par renforcement, nous avions besoin de données de comparaison, à savoir au moins deux réponses du modèle, classées par ordre de qualité. Pour obtenir ces données, nous avons repris les conversations que les entraîneurs avaient eu avec le chatbot. Nous avons sélectionné au hasard un message écrit par le modèle, avons échantillonné plusieurs variantes de suites possibles et avons demandé aux entraîneurs d’IA de les classer. Ces modèles de récompense nous ont alors permis d’affiner le modèle selon une stratégie d’optimisation de la politique proximale. Nous avons répété ce processus à plusieurs reprises.
ChatGPT a été affiné à partir d’un modèle de la série GPT‑3.5 dont l’entraînement s’est terminé début 2022. Pour en savoir plus sur les modèles de la série 3.5, cliquez ici. ChatGPT et GPT‑3.5 ont été entraînés sur une infrastructure de supercalculateurs d’IA Azure.